Maandagochtend, MT-overleg. Het dashboard staat op het scherm. De conversie van "voorgesteld aan opdrachtgever" naar "plaatsing" staat op 30%. Vorig kwartaal was dat 45%. Er wordt gefronst, er komt een actieplan, en de teamleider mag uitleggen wat er misgaat bij zijn recruiters.
Alleen: die 30% is geen drop. Het is een rekenfout. En dat is het vervelende aan verkeerde cijfers. Ze zien er precies zo betrouwbaar uit als goede cijfers. Je stopt tijd, aandacht en geld in een probleem dat er niet is, terwijl het échte probleem onzichtbaar blijft.
In deze blog lopen we de tien meest voorkomende reken- en denkfouten langs die wij regelmatig terugzien in dashboards van uitzendbureaus, detacheerders en recruitmentbureaus. Gebouwd door bureaus zelf, of door een BI-partij waar de branchekennis niet op orde is. Per fout: wat er gebeurt, en wat het je kost als je hierop fout stuurt. Aan het eind staat een test waarmee je binnen een middag ziet of jouw cijfers hier ook last van hebben.
Dashboard uitzendbureau: geen dataprobleem, maar een sturingsfout
Een fout in een rapportage voelt als iets voor de techneuten. Iets om "een keer op te pakken". Maar zodra je op die cijfers stuurt, is het geen dataprobleem meer.
Je beoordeelt recruiters op ratio's die niet kloppen. Je schuift marketingbudget naar een kanaal dat het alleen op papier goed doet. Je zet een forecast in je jaarplan die structureel te hoog is. En iedereen denkt dat er datagedreven gestuurd wordt. Dat geeft een vals gevoel van controle.
Verkeerd gebouwde cijfers zien er precies zo betrouwbaar uit als goede cijfers.
Wat het extra lastig maakt: op de grote hoop valt dit niet op. Een conversie van 30% over duizenden matches ziet er plausibel uit.
De 10 meest gemaakte rekenfouten in dashboards van uitzendbureaus
Hieronder de 10 meest gemaakte rekenfouten in dashboards van uitzenders en detacheerders.
1. Lopende matches meerekenen in conversie en doorlooptijd
Dit is de fout die we het vaakst zien, en ook de fout met de grootste impact op je funnel.
Een kandidaat staat nu in de fase "voorgesteld aan opdrachtgever". Is die match geconverteerd? Nee. Afgevallen? Ook niet. Je weet het simpelweg nog niet. Pas als de opdrachtgever hem afwijst of op gesprek uitnodigt, weet je waar deze match thuishoort.
En toch belanden lopende matches in heel veel dashboards gewoon in de noemer. Alles wat ooit die fase heeft aangeraakt wordt geteld, en alleen wie doorstroomde geldt als succes.
Pak de volgende situatie:
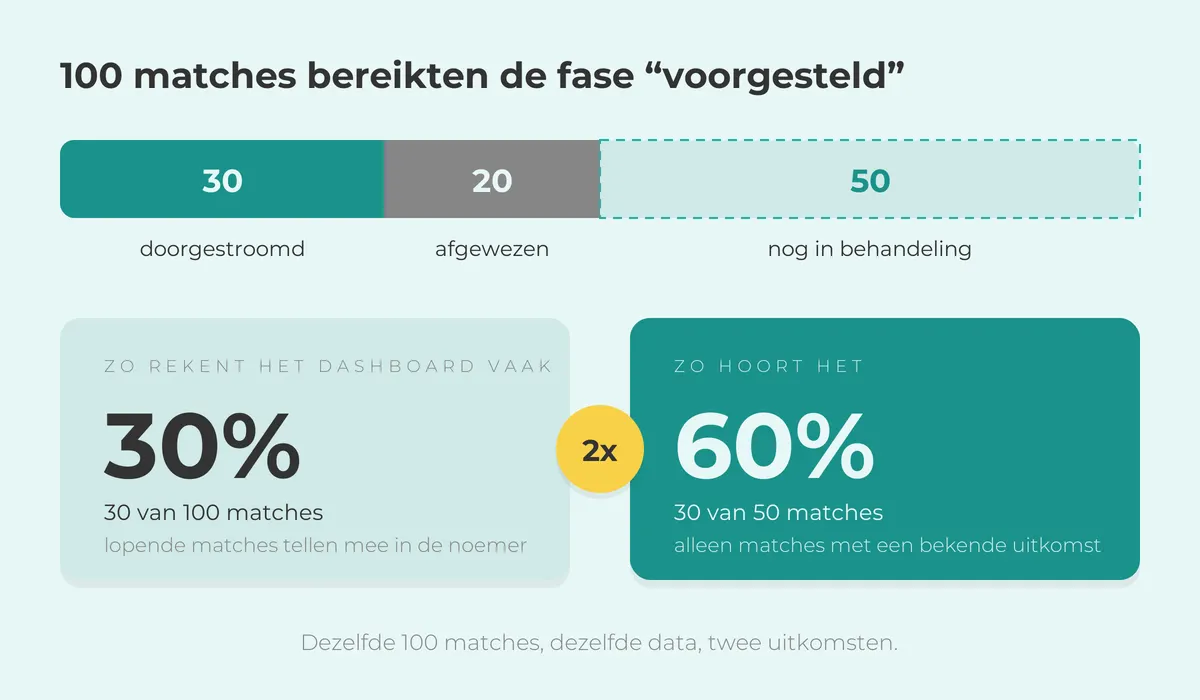
Letterlijk gerekend komt je conversie op 30% (30 van de 100). Reken je alleen over de matches waarvan de uitkomst bekend is, dan is het 30 van 50: 60%. Twee keer zo hoog, met dezelfde data.
Bij doorlooptijden werkt hetzelfde mechanisme, maar dan de andere kant op. Als je alleen afgeronde procedures meet, mis je de procedures die nu al twee maanden stilstaan. Die zijn nog niet af, dus ze zitten nergens in je gemiddelde. Je gemiddelde doorlooptijd ziet er daardoor beter uit dan de werkelijkheid, precies op het moment dat je hem het hardst nodig hebt.
Extra vervelend: dit gaat mee met je groei. Groei je hard, dan heb je relatief veel lopende matches en zakt je "conversie" zonder dat er íets veranderd is in je proces. Precies het moment waarop je het niet wil.
Impact:
je funnel lijkt half zo goed te presteren als hij werkelijk is. Je zet een verbetertraject in op een stap waar het probleem niet ligt, en je beoordeelt de recruiter met de meeste lopende procedures het strengst.
De oplossing:
reken conversie alleen over matches met een bekende uitkomst, en zet het aantal lopende matches als apart getal ernaast. Dan zie je conversie én werkvoorraad, zonder dat het één het ander vervuilt.
2. Niet corrigeren van foutieve registratie van matchfases in het ATS
Vraag een intercedent hoe hij een procedure vastlegt en je krijgt het eerlijke antwoord: zo goed als het gaat, tussen twee telefoontjes door.
Fases die worden overgeslagen omdat de kandidaat al bij de klant op gesprek zat. Procedures die teruggaan naar een eerdere stap omdat de opdrachtgever twijfelde. Dubbele registraties omdat twee collega's dezelfde kandidaat oppakten. In de praktijk komt het allemaal voor, bij elk bureau en in elk ATS.
Reken je conversie en doorlooptijd met de geregistreerde data, dan gaat het scheef. Een conversie boven de 100% wordt dan mogelijk, want er kunnen meer matches uit een fase komen dan er volgens de registratie in zijn gegaan.
Voorbeeld:
100 matches zijn geregistreerd op "intake", maar 12 kandidaten zijn direct op "voorgesteld" gezet zonder ooit een intake in het systeem te krijgen. Dan komen er 112 matches uit een fase waar er 100 in gingen.
En dat is een probleem. Als 112% kan, dan kan er net zo goed 60% staan waar 80% hoort. Je weet niet welke richting de afwijking op gaat.
Wil je weten of dit in jouw dashboard uitzendbureau speelt? Zoom dan in op één vestiging en één week. Op de grote hoop verdwijnen dit soort fouten in het gemiddelde. Verderop in deze blog staat de volledige test.
Belangrijk: dit is geen slordigheid van je team. Het proces is nu eenmaal rommelig, en dat is prima. Je dashboard en eigenlijk je datacorrigerende laag moet daarmee om kunnen gaan. Dat kan met logica die ontbrekende fases aanvult: bereikt een match fase 5, dan heeft hij fase 3 en 4 in de echte wereld doorlopen, ook al is dit niet zo geregistreerd.
Impact:
je kunt niet sturen op je conversiecijfers, in geen enkele richting. Je hebt een mooie visualisatie, maar hij slaat kant noch wal.
De oplossing:
spreek af hoe je omgaat met overgeslagen en teruggezette fases, en leg die regel vast in je datamodel. Niet in het hoofd van degene die het dashboard bouwde. Leg dit zo laag mogelijk in het datamodel vast, zodat ook latere toepassingen waarbij historische context nodig is (bijvoorbeeld AI) hier de vruchten van plukken.
3. Verlengingen die als nieuwe plaatsing meetellen
Voor de meeste uitzenders en detacheerders zijn verlengingen het halve bedrijf. Fijn voor de omzet, verwarrend voor je dashboard.
Maak jij bij iedere verlenging een nieuwe plaatsing aan in je systeem? Dan is de kans groot dat je dashboard die verlenging leest als een nieuwe plaatsing. Met een starter erbij, en aan het eind van de vorige plaatsing een stopper. Commercieel is dat natuurlijk iets heel anders. Een verlenging is een verlenging: geen nieuw resultaat van je sales- of recruitmentinspanning.
Stel: een week met 25 nieuwe plaatsingen op het dashboard. Zestien daarvan blijken verlengingen. Dan heb je er negen echt nieuw binnengehaald, en heeft je team een compliment gekregen voor bijna drie keer zo veel.
Het loopt door in meer cijfers dan je denkt. Je verloop lijkt hoger, want elke verlenging levert ook een kunstmatige stopper op. En je gemiddelde plaatsingsduur lijkt korter: een opdracht van twaalf maanden die elk kwartaal verlengd is, staat in je data als vier plaatsingen van drie maanden.
Impact:
je stuurt je sales op een volume dat niet bestaat. Je forecast op new business is te rooskleurig, en je gaat op zoek naar de oorzaak van een verloopprobleem dat je niet hebt.
De oplossing:
markeer verlengingen als verlenging, of rijg opeenvolgende plaatsingen van dezelfde kandidaat bij dezelfde klant automatisch aan elkaar tot één opdracht. En zet ze op je dashboard als eigen KPI naast de nieuwe plaatsingen, want een hoog verlengingspercentage is juist een cijfer om trots op te zijn.
4. Niet bewust kiezen tussen gewogen en ongewogen gemiddelden
Als je naar bijvoorbeeld de gemiddelde marge per uur kijkt, weet je dan of dat cijfer gewogen of ongewogen is? Dat is de vraag die in veel MT's stilte oplevert.
Kort gezegd: bij een ongewogen gemiddelde telt elke deal even zwaar, hoe groot of klein hij ook is. Bij een gewogen gemiddelde telt elke deal mee naar omvang, meestal naar uren. Twee heel verschillende getallen. Allebei mogelijk, maar welke verwacht jij?
Rekenvoorbeeld met twee deals
Stel, je sluit twee deals. Deal A: twee uitzendkrachten, 40 uur per week, €5 marge per uur. Deal B: één uitzendkracht, 8 uur per week, €14 marge per uur.
Ongewogen, dus per deal: (€5 + €14) / 2 = €9,50 per uur. Gewogen, dus naar uren: (80 × €5 + 8 × €14) / 88 = €5,82 per uur.
Beide getallen zijn correct. Maar ze beantwoorden een andere vraag. Wil je weten wat je commercieel afspreekt op nieuwe deals, los van de grootte? Dan is ongewogen bruikbaar: je ziet dan of je onderhandelt zoals je wil onderhandelen. Wil je weten welke marge je vorig kwartaal echt hebt gedraaid? Dan moet je gewogen rekenen, anders staat er een getal in je stuurinformatie dat nergens in je administratie terugkomt.
Beide getallen zijn correct. Maar ze beantwoorden een andere vraag.
Hetzelfde speelt bij je gemiddelde doorlooptijd (per vacature of per match?) en bij je gemiddelde uurtarief. Overal waar het woord "gemiddeld" staat, staat het resultaat van een keuze die ooit bewust of onbewust is gemaakt.
Impact:
in dit voorbeeld €3,68 verschil per uur, op precies hetzelfde kwartaal. Voer je dat ongewogen cijfer in je jaarplan in, dan reken je met bijna twee keer de marge die je werkelijk draait.
De oplossing:
maak een bewuste keuze voor gewogen of ongewogen. En zet het label erbij op je dashboard. "Gemiddelde marge per uur, gewogen naar gewerkte uren" is vier woorden langer en voorkomt een half jaar discussie.
5. Tijdsperioden door elkaar halen in ratio's
De klassieker bij succespercentages en vulratio's. En begrijpelijk, want de foute variant klinkt volstrekt logisch.
Je zet alle vacatures die in Q2 de status "ingevuld" kregen af tegen alle vacatures die in Q2 zijn aangemaakt. Twee cijfers, allebei uit Q2, klaar. Maar een deel van die gevulde vacatures kwam uit Q1, of nog eerder. Je noemer en je teller gaan over verschillende groepen vacatures.
Stel: 200 nieuwe vacatures in Q1, 80 in Q2, en in Q2 vul je er 90. Dan staat er 113% op je dashboard. Iedereen weet dan dat het niet klopt. Vervelender is het geval waarin er 78% staat, want dan gelooft iedereen het. Terwijl dat net zo min klopt.
De zuivere definitie is het toepassen van een cohort: van de vacatures die in Q2 zijn aangemaakt, welk deel is uiteindelijk ingevuld? Nadeel: zo'n cohort moet rijpen. Vacatures uit juni kunnen in augustus nog gevuld worden. Een lopend kwartaal vergelijk je dus nooit één op één met een afgesloten kwartaal, want het lopende kwartaal is nog niet uitgerijpt. Even wachten, maar dan heb je wel een juist sturingscijfer.
Impact:
afwijkingen in beide richtingen, en ze zitten precies op de cijfers waarmee je mensen beoordeelt. Recruiter A lijkt uitstekend te presteren, maar krijgt vooral steeds minder nieuwe vacatures binnen. Zijn oude vacatures vullen zich, zijn noemer krimpt, en zijn succespercentage schiet omhoog.
De oplossing:
kies per ratio één tijdsperiode en houd teller en noemer in dezelfde groep. En zet bij elk cohortcijfer hoeveel van de groep nog openstaat.
6. Geen correctie voor verzuim, verlof en feestdagen in de forecast
Als iemand via jou aan het werk gaat, weet je één ding zeker: hij werkt niet de hele looptijd elke week het volledige aantal uren. Er is verlof, er zijn feestdagen, en er is ziekte. Toch rekenen veel forecasts met contracturen × weken.
Stel: een plaatsing van zes maanden, 40 uur per week, 26 weken, dus 1.040 uur. Het wettelijk minimum aan vakantie is bij 40 uur 20 dagen per jaar. Over een half jaar: 10 dagen, 80 uur. Neem daarnaast 4 feestdagen die op een werkdag vallen: 32 uur. Volgens het CBS lag het ziekteverzuim van werknemers in het eerste kwartaal van 2026 op 5,8%, hoger dan het langjarig gemiddelde van 5,0% sinds 1996. Over de resterende 928 uur is dat ongeveer 54 uur.
Blijft over: 874 uur in plaats van 1.040. Zestien procent minder. Bij €8 marge per uur is dat €6.992 in plaats van €8.320. Een verschil van €1.328, op één plaatsing. Heb je er honderd lopen, dan praat je over ruim een ton die nooit gaat komen.
En dit is nog de nette variant. In de praktijk zitten er ook onbetaald verlof, kortere werkweken in de zomer, niet declarabele uren en vroegtijdig gestopte plaatsingen in.
Impact:
je rekent jezelf rijk, elke maand opnieuw. En omdat de afwijking groot en structureel is, gebeurt er iets dat nog erger is dan een fout cijfer: niemand vertrouwt de forecast meer, en dan wordt er weer op gevoel besloten.
De oplossing:
bouw de correctie in lagen op, zoals hierboven, en ijk hem daarna op je eigen historie. Vergelijk de gefactureerde uren van vorig kwartaal met de forecast van dat kwartaal, en gebruik dat percentage. Je eigen realisatie is een betere voorspeller dan elk branchegemiddelde. Meer over de opbouw van dit soort cijfers lees je in de 8 belangrijkste KPI's voor bureaus in de arbeidsbemiddeling.
7. Kanaalperformance meten zonder journey-logica
Een marketingvergadering begint bijna altijd met dezelfde vraag: welk marketingkanaal zeggen we op en welke niet?
Om die vraag te beantwoorden wil je weten welk kanaal kwalitatieve kandidaten en plaatsingen oplevert. En dan blijkt de reis van een kandidaat zelden een rechte lijn. Solliciteren op vacature A, afgewezen worden, drie maanden later handmatig gematcht aan vacature B, en dáár geplaatst worden. Of binnen één week reageren via drie verschillende kanalen.
Een journey is die hele reis, van eerste sollicitatie tot eventuele plaatsing. Alles wat er onderweg gebeurt, is een touchpoint. Bij bronbepaling kijk je naar alle touchpoints binnen die reis en kies je bewust welke het meest bepalend was. Vaak is dat de eerste bron binnen de journey. Zo werken wij met journeys.
Doe je dat niet, dan gebeurt er meestal één van twee dingen. Of de plaatsing gaat naar de bron die de kandidaat twee jaar geleden in het ATS zette, want dat is het eerste bronveld op de kandidaatkaart. Of hij gaat naar de laatste sollicitatie, terwijl een heel andere sollicitatie de procedure in gang zette.
Impact:
je zet marketingbudget in bij kanalen die alleen op papier goed draaien, en je zegt het kanaal op dat het echte werk deed. Bij een mediabudget van een paar duizend euro per maand is dat direct geld.
De oplossing:
bepaal de bron op journeyniveau, niet op sollicitatie- of kandidaatniveau, en leg vast welk touchpoint wint. Kijk daarnaast naar meer dan plaatsingen alleen: een kanaal dat veel kandidaten aanlevert die het tot de shortlist halen, heeft ook waarde.
Bind je niet vast aan de 100%, die is onhaalbaar. Maar laat je daardoor ook niet ontmoedigen om wel de stappen naar de 100% te zetten. Veel bureaus zitten op dit thema echt nog maar op 30% van wat mogelijk is, en dat is écht te laag om je marketingbudget effectief in te zetten.
8. Plaatsingen tellen in plaats van uren, omzet of marge
Plaatsingen zijn makkelijk te tellen. Daarom staan ze op vrijwel elk dashboard, hangen ze in de vestiging aan de muur en zitten ze in de bonusregeling.
Maar een plaatsing van drie weken voor 16 uur per week met €4 marge is iets heel anders dan een jaarplaatsing van 40 uur met €9 marge. In je telling wegen ze precies even zwaar.
Stel: vorig jaar 40 plaatsingen, gemiddeld 900 uur, gemiddeld €8 marge per uur. Dat is €288.000 marge. Dit jaar 46 plaatsingen, gemiddeld 650 uur, gemiddeld €7,50 marge. Dat is €224.250. Zes plaatsingen meer, en toch 22% minder marge.
We komen zelfs plaatsingen tegen met een negatieve marge waar wel een bonus voor wordt uitgekeerd. De vlag hangt uit, maar moet je hier wel blij mee zijn?
Op het dashboard staat het als groei. In de winst- en verliesrekening staat het als een slecht jaar. En dat verschil komt pas boven water als de cijfers al vaststaan, terwijl je het in maart had willen zien.
Impact:
schijnsucces, en het duurt lang voordat je het merkt. Je plaatsingen worden korter, vaker vroegtijdig opgezegd en draaien minder uren per week, maar je hoofd-KPI gaat omhoog.
De oplossing:
zet naast het aantal plaatsingen altijd de verwachte uren en marge van die plaatsingen. Dan zie je niet alleen hoeveel je plaatst, maar ook wat het waard is. Voor detacheerders werkten we dit verder uit in de blog over de belangrijkste stuurinformatie voor detacheerders.
9. Kandidaten en matches door elkaar halen
"Twee van de tien procedures ronden we succesvol af, dus we zitten op 20%." Klinkt helder. Maar wat is de eenheid: een kandidaat of een match?
Dat lijkt een detail. Het is het verschil tussen twee cijfers die een factor twee uit elkaar liggen.
Stel dat een kandidaat gemiddeld twee procedures tegelijk heeft lopen, wat bij uitzenden en detachering heel normaal is. Dan plaats je 2 van de 10 kandidaten, dus 20% op kandidaatniveau. Op matchniveau plaats je 2 van de 20: 10%. Beide cijfers zijn juist. Ze zeggen alleen iets anders.
Wanneer gebruik je wat? Kandidaatniveau vertelt je iets over de kwaliteit van je instroom en je marketing: hoeveel van de mensen die we binnenhalen, zetten we aan het werk. Matchniveau vertelt je iets over je proces en je funnel: hoeveel voorstellen zijn er nodig voor één plaatsing.
Impact:
vooral vervelend bij het voorspellen van je funnel. Reken je met de verkeerde eenheid, dan verwacht je twee keer zo veel plaatsingen als er aankomen. En met een verkeerde verwachting neem je verkeerde beslissingen over wat je team deze maand moet aanjagen.
De oplossing:
zet de eenheid in de titel van elke grafiek. "Conversie per matchfase (matches)" of "Plaatsingsratio (kandidaten)". Twee woorden extra, nul discussie.
10. De boekhouding gebruiken als basis voor je commerciële stuurinformatie
Op het eerste gezicht lijkt dit heel logisch: de commerciële kant van je business aansturen met data uit de boekhouding. En deels klopt dat ook. Maar alleen als je terug wilt kijken.
Het verleden is goed om te weten, maar je kunt er niets meer aan veranderen. Dus als je jouw commerciële team wilt sturen, dan ben je met het verleden eigenlijk al te laat. Je wilt proactief zijn, je wilt weten waar je exact staat voor de komende periode, zodat je bij kunt sturen als dit nodig is.
Impact:
het ontbreken van goede manieren om vooruit te kijken zorgt ervoor dat je altijd te laat bij gaat sturen. Je wilt bijsturen voordat het probleem definitief is, niet pas achteraf. Als het erop lijkt dat volgend kwartaal niet op de doelstelling uit gaat komen, wil je dat gesprek nu voeren. Niet als het kwartaal al afgelopen is.
De oplossing:
stuur je commerciële teams aan op basis van een financiële forecast. Eentje die gebaseerd is op de contracten en plaatsingen die je al hebt lopen en die deze afzet tegen de doelstelling die gesteld is. Zo zie je exact wat er nog aan nieuwe plaatsingen bijgeplust moet worden, om de doelstelling te gaan behalen. Een voorwaarde is hier wel dat de financiële forecast geavanceerd moet zijn en bijvoorbeeld rekening houdt met verzuim, verlof en feestdagen. Meer weten? Lees: Hoe een realtime financiële forecast bureaus helpt om actief bij te sturen.
Zo test je in een middag of je cijfers kloppen
Je hoeft geen data-analist te zijn om deze fouten in je dashboard uitzendbureau op te sporen. De truc: maak de dataset zo klein dat je hem met de hand kunt nalopen. Op de grote hoop valt niets op, op één week bij één vestiging wel.
- Filter op één vestiging en één week. Tel de plaatsingen met de hand na in je ATS. Klopt het aantal?
- Zoek een conversie boven de 100%. Kun je die produceren met een filter? Dan zit er een registratie- of periodeprobleem in.
- Vraag naar de noemer. Zitten lopende matches in de conversie, of alleen afgeronde?
- Check een klant met veel verlengingen. Staan die als nieuwe plaatsing in het dashboard?
- Vraag van elk gemiddelde of het gewogen is. Krijg je geen eenduidig antwoord, dan is dat je antwoord.
- Vergelijk je forecast met de realisatie van vorig kwartaal. Structureel 10 tot 20% verschil? Dan ontbreekt de correctie voor verzuim, verlof en feestdagen.
Op de grote hoop valt niets op, op één week bij één vestiging wel.
Werk je met een BI-partij of een interne BI-collega? Dit zijn de vier vragen die je letterlijk kunt stellen: hoe gaan we om met lopende matches, hoe corrigeren we voor overgeslagen fases, wat is de bron van een plaatsing bij meerdere sollicitaties, en zijn onze gemiddelden gewogen of ongewogen?
Dashboard uitzendbureau: aan de slag
Is dit lijstje compleet? Nee. En sommige keuzes zijn ook echt keuzes: er is niet altijd één juiste definitie, er is een definitie die past bij je vraag. Die keuze moet alleen bewust zijn en opgeschreven staan.
Doe morgen één ding. Pak de KPI waar jullie het meest naar kijken en vraag hoe die precies wordt berekend. Het liefst met een begrijpelijk voorbeeld. Detailvragen hierover zijn nooit 'domme' vragen.
Wat wij in de praktijk zien: deze fouten kosten vooral leergeld bij bureaus die dit pad voor het eerst lopen. Bij standaard dashboards zijn de kinderziektes er meestal al uit of worden meerdere situaties standaard ondersteund, omdat iemand anders dat leergeld betaalde. Meer over die afweging lees je in standaard dashboards of inhouse organiseren, en over de invoering in succesvol dashboards implementeren als uitzender of detacheerder.
Twijfel je of een van deze tien in jouw dashboard uitzendbureau zit? Stuur me gerust een berichtje. Sparren over de KPI's in de arbeidsbemiddeling is precies het soort gesprek waar ik vrolijk van word!
Veelgestelde vragen
Welke KPI's horen op een dashboard uitzendbureau?
Begin met de KPI's die je funnel en je marge zichtbaar maken: nieuwe vacatures, conversie per matchfase, doorlooptijd tot plaatsing, starters en stoppers los van verlengingen, gewerkte uren en marge per uur. Belangrijker dan de lijst is dat van elke KPI vastligt hoe hij berekend wordt.
Kan een conversie in een dashboard boven de 100% uitkomen?
Nee, en daarom is dat altijd een signaal dat de berekening niet klopt. Het gebeurt als er meer matches uit een fase komen dan er volgens de registratie in zijn gegaan, bijvoorbeeld doordat fases worden overgeslagen. Ook het vermengen van tijdsperioden veroorzaakt het: gevulde vacatures uit dit kwartaal afzetten tegen alleen de vacatures die dit kwartaal zijn aangemaakt.
Moet ik gewogen of ongewogen gemiddelden gebruiken?
Dat hangt af van je vraag, en beide zijn juist. Wil je weten wat je per deal commercieel afspreekt, los van de grootte, gebruik dan ongewogen. Wil je weten wat je echt hebt gerealiseerd, bijvoorbeeld de marge per uur over een kwartaal, dan moet het gewogen. Een goed dashboard ondersteunt beide. Het gevaar zit in niet weten welke van de twee je bekijkt.
Hoeveel uren moet ik aftrekken voor verzuim en verlof in een forecast?
Reken nooit met de bruto contracturen. Een opbouw die werkt: haal eerst het verlof eraf (het wettelijk minimum is vier keer de wekelijkse arbeidsduur per jaar), dan de feestdagen die op een werkdag vallen, en pas daarna een verzuimpercentage over de resterende uren. Het ziekteverzuim van werknemers lag volgens het CBS in het eerste kwartaal van 2026 op 5,8%.
Zitten deze rekenfouten ook in een standaard dashboard uitzendbureau?
Dat kan, maar de kans is kleiner. Standaard dashboards zijn bij tientallen bureaus in gebruik, waardoor zo'n fout eerder opvalt en één keer wordt opgelost voor iedereen. Bouw je zelf, of met een partij zonder ervaring in de arbeidsbemiddeling, dan kom je deze tien fouten vaker tegen.
Hoe vaak moet ik de cijfers in mijn dashboard uitzendbureau controleren?
Twee keer per jaar een steekproef is voor de meeste bureaus genoeg, plus altijd na een wijziging in je ATS of werkproces. Nieuwe matchfases, verlengingen anders registreren of een nieuw type opdracht: dat zijn de momenten waarop definities stilzwijgend schuiven. Zet die controle bij één eigenaar in de agenda.
Vragen over dit artikel of over de cijfers van jouw bureau? Plan een demo, dan kijken we er samen naar.